在ISEF备赛过程中,许多学生花费大量精力收集数据并生成精美图表,却在被追问某个关键数字时只能凭记忆解释。问题通常不在于实验没有做,而在于分析路径没有留下来:清洗在哪一步做的、哪个脚本生成哪张图、随机种子是多少、软件版本是否变化,都无法快速说明。研究记录证明你做过实验,可复现分析则让别人能从原始数据重新跑出同一张图、同一个数字。对于使用Excel、R、Python或仪器软件处理数据的学生而言,ISEF代码与数据留存的核心,就是建立一条可被他人复核的计算路径。
区分研究记录本与可复现分析包
传统实验记录本侧重时间线、观察现象和手动计算,核心目的是留证。可复现分析包则是一个动态数字工作流,核心目的是验证。它不仅包含数据,还包含把数据转化为结论的脚本、参数和说明。如果复核者拿到你的原始数据、脚本和README,能在自己的电脑上运行出与论文中一致的统计结果,你的项目就具备更高的透明度和严谨性。这种能力在涉及复杂数据处理、问卷清洗、图像分析或机器学习时尤其重要,因为它减少“黑箱操作”的嫌疑,也展示你对分析全流程的掌控力。
研究记录与可复现分析不是互相替代,而是互补。记录本回答“你何时做了什么、观察到什么”;分析包回答“你怎样从原始数据得到结果”。如果只有记录本,复核者仍可能不知道某个均值如何算出;如果只有最终图表,连数据来源和排除标准都难以确认。站内关于ISEF研究记录怎么做?分阶段留证方法一次讲清的方法,可以与本文的可复现包结构配合使用。
教学示例:标准化的文件夹树结构
为了便于管理和复核,可以采用以下通用文件夹结构。以下仅是一套教学建议,不代表任何赛事的提交规定,也不要求你使用特定工具。
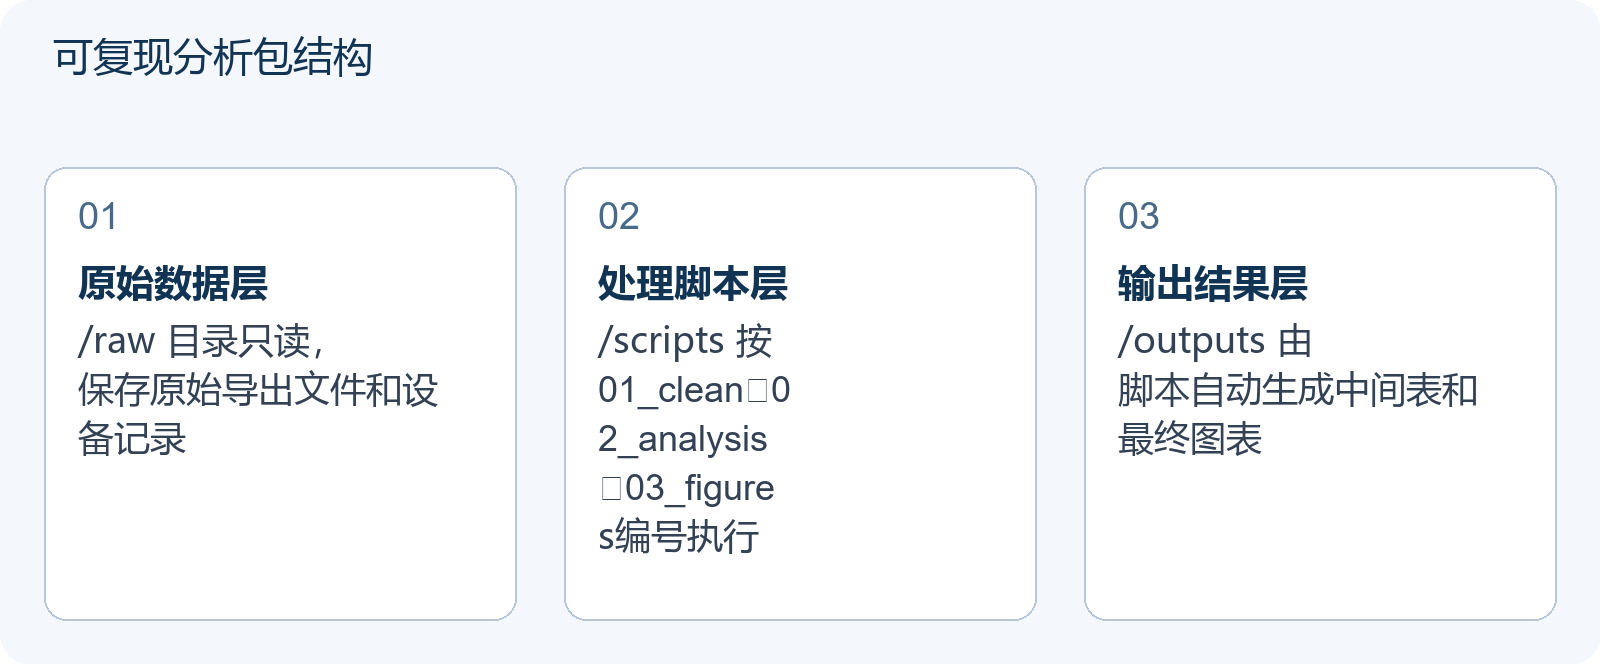
- /raw:存放所有原始数据文件。此目录应设为只读,严禁直接修改原始文件。
- /scripts:存放处理数据的代码脚本。按执行顺序编号,例如
01_clean.py、02_analysis.R、03_figures.py。若使用Excel,可把Power Query步骤、VBA宏或操作说明放在此处。 - /outputs:存放由脚本自动生成的中间数据表和最终图表。此目录内容应由脚本覆盖写入,而非手动保存。
- /docs:存放数据字典、README文档、清洗日志以及任何必要的说明文件。
这种结构确保数据流向的单向性:从原始数据经过脚本处理,最终输出结果。任何对结果的质疑都可以追溯到具体脚本、参数和数据源。若项目使用仪器软件导出数据,可在 /docs 中记录仪器型号、导出设置和导出时间,并把原始导出文件放入 /raw。
README文档的最小必要字段
README是分析包的入口,必须清晰记录环境信息和运行方法。最少应包含以下字段:
- 数据来源与版本:明确数据获取日期、来源机构、文件命名规则,以及文件哈希值(如有)。
- 软件与包版本:列出操作系统、编程语言版本(如Python 3.9)、关键库版本(如Pandas 1.4.0)。这是解决“在我电脑上能跑,在你电脑上报错”的关键。
- 运行顺序:明确指出必须先运行哪个脚本,后运行哪个脚本,以及哪些脚本依赖前一步输出。
- 随机种子:如果分析涉及随机抽样、模拟或机器学习模型,必须固定随机种子,以确保结果一致。
- 输出映射:说明每个输出文件由哪个脚本生成,例如
03_figures.py生成论文图2和图3。 - 已知限制:说明缺失值、设备误差、样本量限制或未纳入分析的变量。
README不需要写成长篇报告,但必须让另一位同学在没有你口头指导的情况下知道从哪里开始、依次运行什么、最后检查哪些数字。
原始数据不动原则与清洗记录
数据清洗是产生偏差的高风险环节。基本原则是“原始数据不动”。所有清洗操作都应在脚本中通过代码实现,并将清洗后的数据另存为新文件。更重要的是,必须在脚本注释或单独日志中记录删除了哪一行、为什么删除。例如,如果排除异常值,需写明排除标准,如“超过均值±3个标准差”或“设备故障标记为-999”。这与ISEF数据清洗记录:怎样说明异常值处理与排除标准中强调的异常值处理说明相辅相成。
教学示例(非真实比赛数据):某次测量原始文件记录2、4、6,以及一条设备故障标记-999。清洗脚本按预先写明的规则排除-999后,剩余均值=(2+4+6)/3=4。README记录排除理由,输出文件保存清洗后数据。此例仅用于说明“原始数据不动、清洗另存、计算可复查”的流程,不代表真实项目结果。
如果使用Excel,可以把Power Query的每一步命名清楚,或把清洗后的工作表另存,并在 /docs 中写明筛选条件。若使用R或Python,应避免在原始文件上直接修改单元格。关于实验记录本与原始数据留证的配合,可参考ISEF 实验记录本怎么记?原始数据留证规范全拆解。
图表与脚本的一一映射
论文或海报中展示的每一张图表,都应在 /outputs 中有对应文件,并由 /scripts 中某个特定脚本生成。避免手动在Excel中调整图表样式后截图插入论文。如果图表需要微调,应修改生成脚本中的绘图参数,重新运行脚本生成新图。可以在README中建立一张简单映射表:图1由03_figures.py生成,图2由03_figures.py生成,表1由02_analysis.R生成。这样复核者能轻易验证图表背后的数据真实性,也减少因手动编辑导致的视觉误导。
如何披露AI代码辅助
随着AI工具普及,学生可能使用AI生成部分代码。披露时,应说明AI的辅助范围,例如“使用AI生成基础数据读取函数”,并说明人工检查点,例如“所有AI生成代码均经过人工逻辑审查和单元测试”。关键是展示你对代码逻辑的理解,而非只依赖工具输出。若学校、导师或赛事有最新学术诚信要求,应按其规定披露;不确定时先询问导师。披露的目的不是自我否定,而是让复核者知道哪些部分由人负责、哪些部分经过验证。
可复现性诊断测试
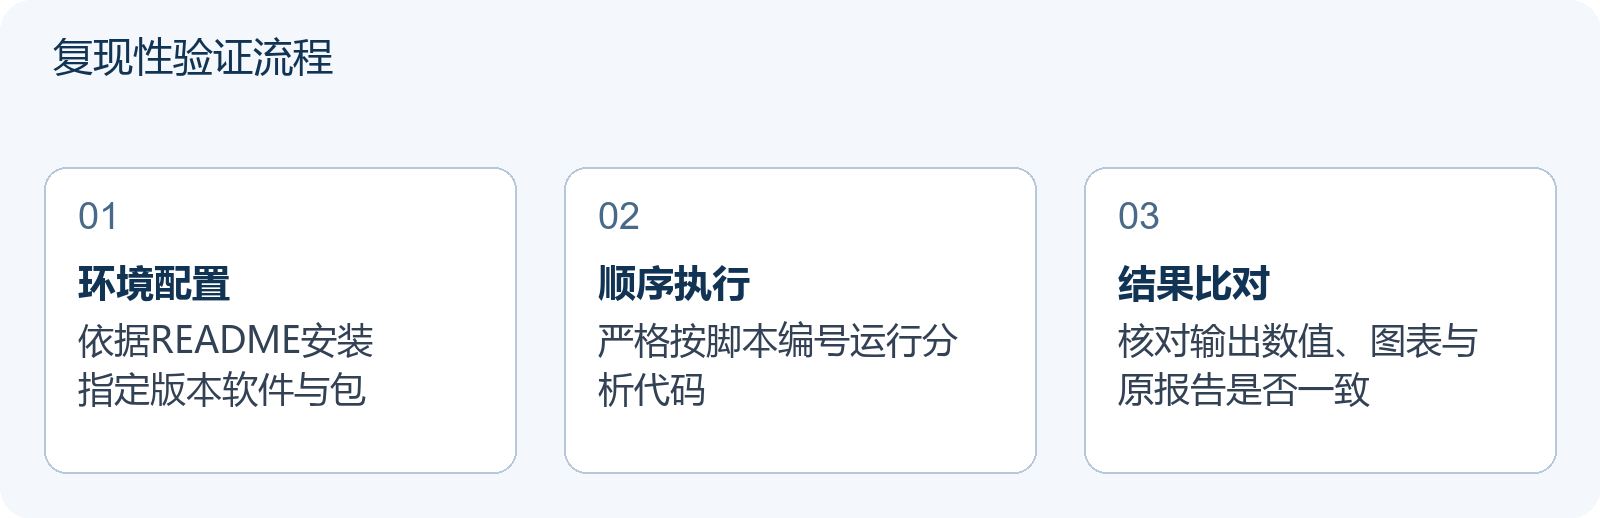
提交前可进行一次“盲测”:邀请一位同学,只给他 /raw 文件夹和 /docs 中的README,不提供额外口头指导。看他能否按照README指示,在你的电脑或他自己的电脑上复现一个关键统计均值或一张核心图表。如果成功,说明分析包具备真正的可复现性;如果失败,通常暴露文档缺失、版本不符或运行顺序不清。把失败点记下来,补进README,而不是口头解释过去。
常见工具栈的落地写法
Excel项目可把原始表放在 /raw,清洗后的表放在 /outputs,用Power Query或VBA固化步骤,并在 /docs 中写明每个查询名称和筛选条件。R项目可使用脚本编号,配合 sessionInfo() 记录包版本。Python项目可用虚拟环境或 requirements.txt 记录依赖,并把随机种子写在分析脚本开头。仪器软件项目应保存原始导出文件,不要只保存处理后的Excel;若软件自动平滑或校正,应记录参数并说明是否可关闭。
提交前检查清单
在最终整理时,逐一确认:原始数据是否只读;清洗后数据是否另存;脚本是否按顺序编号;README是否写明软件版本、运行顺序、随机种子和输出映射;每张图表是否能指向一个输出文件;每个输出文件是否能指向一个生成脚本;AI辅助是否说明范围和人工检查点;是否能请一位同学只靠README复现一个关键数字。完成这些检查后,你的ISEF代码与数据留存就不再只是“文件夹整理”,而是一条可被复核的科学证据链。
把上述结构落到自己的项目上,可以从最小版本开始:先把 /raw 设为只读,再补一个能重跑核心图表的脚本,最后补齐README中的环境、运行顺序与输出映射。这样即使赛事流程没有强制要求提交代码,你的分析过程也已经处于随时可被复核的状态。
常见问题
如果赛事没有要求提交代码仓库,我还需要整理分析包吗?
需要。分析包不是为了满足某个提交动作,而是为了让你自己、导师和复核者能追溯数字来源。即使最终只提交论文和图表,保留 /raw、/scripts、/outputs 和 /docs 也能帮助你在答辩中解释清洗步骤、软件版本和随机种子。
如果我只用Excel做分析,还需要保留脚本吗?
Excel没有传统意义上的脚本时,可以用Power Query查询、VBA宏或步骤说明来固化清洗流程。建议把关键步骤命名,并在 /docs 中写明筛选条件、排除标准和输出位置。重点是让别人能按说明重现同一张表,而不是要求你必须写Python或R。
随机种子是什么,为什么必须记录?
随机种子是控制伪随机数生成器的初始值。在涉及抽样、模拟或机器学习的项目中,固定随机种子能确保每次运行代码得到相同结果。如果不记录,其他人无法复现你的特定结果,也难以判断差异来自数据、代码还是随机过程。