在准备 ISEF(国际科学与工程大奖赛)或其他高水平科研竞赛时,一个常见误区是混淆“测量次数”与“样本量”。许多学生在答辩或论文中声称:“我对每个处理组进行了15次测量”,并以此作为统计显著性的依据。然而,如果这15次读数全部来自同一株植物或同一台仪器,它们在统计学上并不构成15个独立的生物学证据。这种混淆会导致标准误被人为缩小,显著性检验更容易给出过于乐观的结果,最终使研究结论缺乏说服力。
为什么“做了很多次”不等于“有很多独立证据”
科学研究的核心在于可重复性(Replicability)。评委和读者关注的不仅是数据的数量,更是数据的独立性。独立性意味着每一个数据点都代表一个新的、不受前一个数据点直接影响的观测单元。例如,如果你在同一只小白鼠身上连续注射药物并记录心率变化,这些心率数据虽然丰富,但无法证明药物对不同个体的普遍效应,因为它们共享同一个生物体的生理背景。相反,如果你给10只不同的小白鼠分别注射药物,每只测一次心率,这才是10个独立的生物学证据。区分这两者,是构建严谨实验设计的第一步。
三类重复与平行样本
为了准确评估证据强度,我们需要将重复分为三类,并理解“平行样本”在其中扮演的角色。
- 技术重复(Technical Replicates):对同一样本进行多次测量,以评估仪器的精度或操作的一致性。例如,用移液枪吸取同一管溶液三次放入分光光度计读数。技术重复能减少随机测量误差,但不能增加样本对总体的代表性。
- 生物学重复(Biological Replicates):使用不同的个体、批次或来源的样本进行处理。例如,种植三盆不同的番茄植株,分别施加肥料A和B。生物学重复反映了自然变异,是推断总体效应的关键。
- 重复测量(Repeated Measures):对同一个体在不同时间点进行测量。例如,每天测量同一株植物的株高。这类数据具有自相关性,需要特殊的统计模型处理,不能简单视为独立样本。
所谓“平行样本”,通常指同一处理下来自多个独立实验单元的一组样本。例如同一光照条件下的3盆植物、3批独立培养的细胞、3只不同动物。它们不是同一对象的多次读数,而是用于展示处理效应是否在不同独立单元中重复出现。写论文时,一致性证据应描述这些独立单元之间的方向是否一致、变异范围多大,而不是把同一对象的多次读数罗列成“重复”。
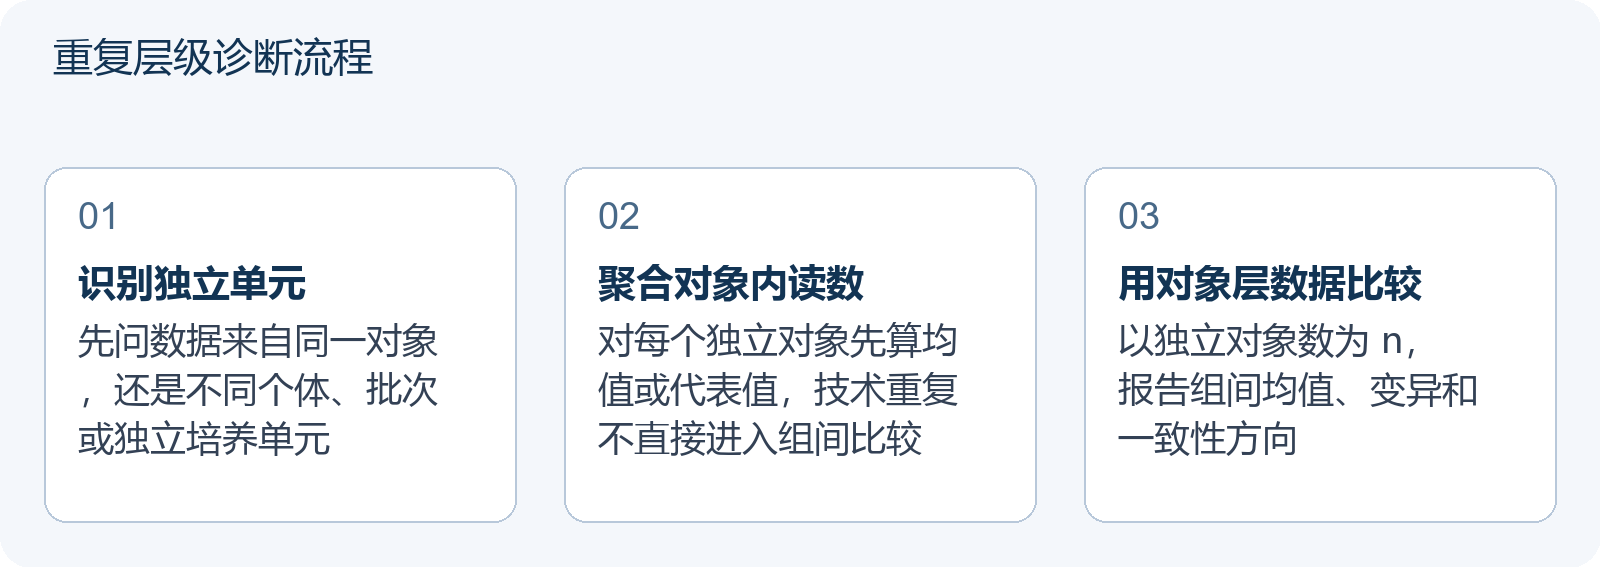
先定独立单位,再算均值和误差
正确的数据处理顺序至关重要。首先确定你的“独立分析单元”是什么。如果研究的是植物生长,且使用了多盆植物,那么每一盆植物就是一个独立单元。对于每一盆植物,你可能测量了5次株高(技术重复),此时应先计算这5次读数的平均值,得到该盆植物的代表值。然后,基于所有盆的平均值来计算组间的差异和误差。如果直接将所有5×N个读数混在一起计算均值和标准差,会忽略盆与盆之间的变异,从而低估不确定性。
教学示例:光照对株高的影响
注意:以下内容为虚构的教学演示,非真实赛题或官方评分标准。
假设你研究两种光照条件(A组和B组)对植物生长的影响。每组有3盆植物(生物学重复 n=3)。每盆植物用尺子测量5次株高(技术重复)。
| 组别 | 盆号 | 5次读数 (cm) | 单盆均值 (cm) |
|---|---|---|---|
| A组 | 1 | 10, 11, 10, 12, 11 | 10.8 |
| A组 | 2 | 11, 12, 11, 10, 12 | 11.2 |
| A组 | 3 | 12, 11, 12, 13, 12 | 12.0 |
| B组 | 1 | 8, 9, 8, 10, 9 | 8.8 |
| B组 | 2 | 9, 10, 9, 8, 10 | 9.2 |
| B组 | 3 | 10, 9, 10, 11, 10 | 10.0 |
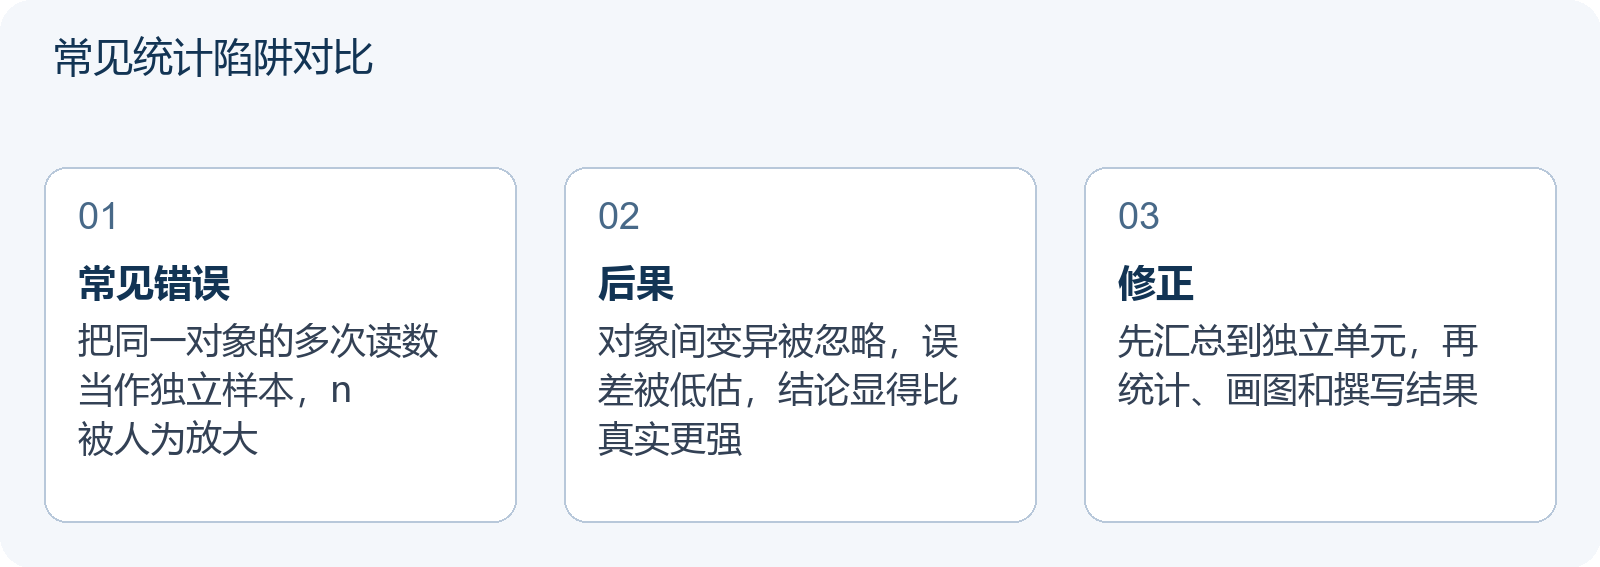
错误做法:把每组15个读数都当作独立样本(总 n=30),计算A组均值约11.33,B组均值约9.33,得出差值2.0 cm,并认为样本量大因此结果非常可靠。
正确做法:先计算每盆均值。A组三个均值为10.8、11.2、12.0,平均为11.33;B组三个均值为8.8、9.2、10.0,平均为9.33。差值为2.0 cm。但在进行t检验或报告误差棒时,自由度应基于 n=3(每组3个独立单元),而非 n=15。这意味着基于盆间变异估计的不确定性会更真实,结论更保守。在这个示例中,A组三盆均值都高于B组三盆均值,方向一致;但由于每组只有3个独立单元,不能把这种一致性夸大为普遍规律。
记录表字段设计建议
为了避免后期分析混乱,建议在原始数据记录表中明确包含以下字段:
- 对象编号:唯一标识符,如 Plant_01。
- 处理组:所属的实验条件,如 Light_A。
- 测量层级:标记这是技术重复、生物学重复还是时间点测量,如 Trial_1。
- 原始读数:实际测量值。
- 汇总单位:这一行最终汇入哪个独立单元,如 Plant_01。
- 汇总规则:备注如何从原始读数生成分析单元的值,如 Mean_of_Trials。
清晰的元数据有助于在撰写论文方法部分时,准确描述数据处理流程,也能让评委快速判断你的 n 到底代表什么。
论文中怎样写出一致性证据
在方法(Methods)部分,明确指出独立分析单元。例如:Each pot was treated as an independent biological replicate. Height measurements were averaged across five technical replicates per pot.
在结果(Results)部分,报告基于独立单元的均值和标准误(SEM)或标准差(SD)。图表中的误差棒应反映生物学重复间的变异,而非技术重复间的变异。若 n 很小,最好同时展示每个独立单元的点,而不是只放一个光秃秃的柱状图。
在讨论(Discussion)部分,承认样本量限制。如果 n=3,应说明结论适用于当前测试的个体范围,并建议未来研究增加生物学重复以提高普适性。不要把“同一盆测了5次”写成“做了5个平行样本”。
自查清单:评审视角
假设一位评审拿到你的原始数据表,他能否一眼看出:
- 哪个变量定义了“独立样本”?
- 为什么选择这个层级作为分析单元?
- 技术重复是否被正确聚合,而不是被误当作独立证据?
如果答案模糊,你需要重新整理数据呈现方式。参考ISEF研究记录怎么做?分阶段留证方法一次讲清了解如何规范记录过程,以及ISEF数据清洗记录:怎样说明异常值处理与排除标准学习如何处理数据异常。
此外,确保你的研究问题足够聚焦,以便在有限资源下获得足够的生物学重复。可以参考ISEF研究问题收窄:从宏大目标到一个能够检验的变量关系来优化选题。
常见问题
如果我只有一株植物,能做生物学重复吗?
不能。一株植物只能提供技术重复或时间序列数据,不能代表多个独立生物个体。要获得生物学重复,必须使用多个独立个体,如多株植物、多只动物或多份独立培养物。
技术重复越多越好吗?
技术重复有助于提高单次测量的精度,减少仪器噪声。但一旦测量精度满足要求,继续增加技术重复不会提高处理效应的统计功效。资源应优先用于增加生物学重复。
论文中应该报告SD还是SEM?
取决于目的。SD描述独立单元之间的变异程度,适合展示数据分布;SEM估计均值的精确度,适合用于推断总体均值。若独立单元是盆,误差棒应基于盆层数据,而不是同一盆内的技术读数。