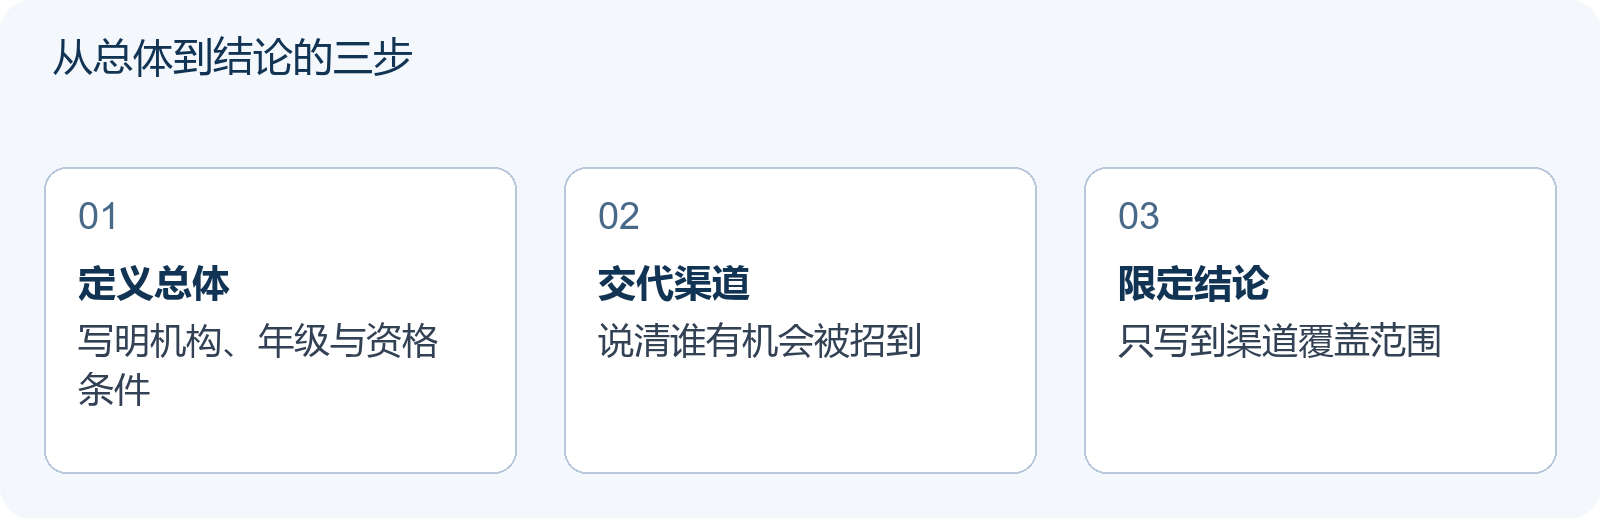
一句话回答:ISEF问卷样本的招募顺序是“先写清要推断的总体,再说明用什么渠道招到了谁,最后把结论限定在这个渠道能覆盖的范围内”。份数本身不能证明代表性;200份便利样本仍需写清覆盖缺口,80份分层样本也不能自动代表全校。需要说明:本站不是Society for Science或其附属机构的官方网站,也不自称官方;现有资料未提供ISEF官方问卷样本量或代表性门槛,所以本文不引用“官方最少份数”,只讨论研究方法上站得住的写法。
本篇与站内《ISEF问卷研究准备:先检查题目能否测到你想研究的概念》分工不同:那一篇解决“题目有没有测到目标构念”,本篇解决“谁被抽到、通过什么渠道被抽到、结论能推到哪里”。前者是问卷定稿前的活,后者是招募与写作阶段的活。
一、先定义总体,再决定去问谁
总体就是你希望结论所描述的那群人。写总体至少要三个限定:机构或地理范围、年级或年龄范围、与主题相关的资格条件。例如“某市三所公立高中、高一至高三、近一学期使用过校内自习室的学生”,这是一个可以交代招募路径的总体;“高中生”不是总体,是一个愿望。
常见失误是总体写得很大、抽样做得很小。题目若是“自主学习时长与睡眠质量的关系”,而你只在高三晚自习班发放问卷,那么数据实际描述的总体只能是“某校高三晚自习学生”。此时任何跨年级比较都超出了样本覆盖范围,哪怕讨论部分写得再客气,也补不回结构缺口。研究假设里写下的预测方向,同样要与这个总体对应,可对照站内《ISEF研究假设:把预测方向、测量方法与可能反例写清楚》。
二、三类招募渠道的偏差方向对照
讨论偏差时不要只说“可能有偏差”,要说清偏向哪一侧、为什么。渠道机制决定了谁容易进来、谁被系统性漏掉。
| 招募渠道 | 谁容易进入样本 | 谁被系统性漏掉 | 可预期的偏差方向 |
|---|---|---|---|
| 按名单等比例分层随机(按全年级名单在各年级按比例抽人) | 名单内符合条件者按既定抽样概率被抽中,配合度是主要损耗 | 拒绝填写者、当天缺席者 | 设计上可控制随机误差,但非响应仍可能带来偏差;需报告回收率与缺席情况 |
| 社团群、竞赛群、家长群转发 | 参与度较高、对主题本身有兴趣的人 | 不活跃学生、不关注该类信息的家庭 | 在“家庭支持”“课外投入”类变量上可能偏高 |
| 公开线上链接(社交平台公开转发) | 主动点开并完成的人 | 沉默者、不感兴趣者、网络使用少的人 | 典型的自选样本,比例估计方向不可预设 |
注意最后一行:自选样本的偏差方向常常无法预判,这本身就是必须写进局限的事实。而家长群渠道的偏差方向可以先提出有机制依据的假设,再用分组检查验证——如果你的研究变量恰好是“家庭支持”,那么用家长群招募等于让自变量和招募机制纠缠在一起,不能靠增加份数解决。
三、样本量为什么不能稀释结构偏差
增加样本量降低的是随机波动,不改变系统偏差。做一个纯算术示意(这是逻辑推演,不是实证发现):设目标总体中A类学生占一半,而你的渠道完全接触不到A类。那么无论回收50份还是500份,样本里A类的比例都是0,这一项的偏差都固定为50个百分点——它不会随份数增加而收窄,只会被更精确地重复。这解释了为什么“我收了200份”只是工作量陈述,不是代表性论证。
反过来说,小样本也不必自我否定。80份分层样本可以支撑“在本校三个年级的样本中观察到X与Y同向或反向变化”这类限定表述;它撑不住的是“高中生普遍如此”。结论的强度由抽样机制和表述边界共同决定,份数只是其中一个参数。
四、便利样本也能写:三步可辩护写法
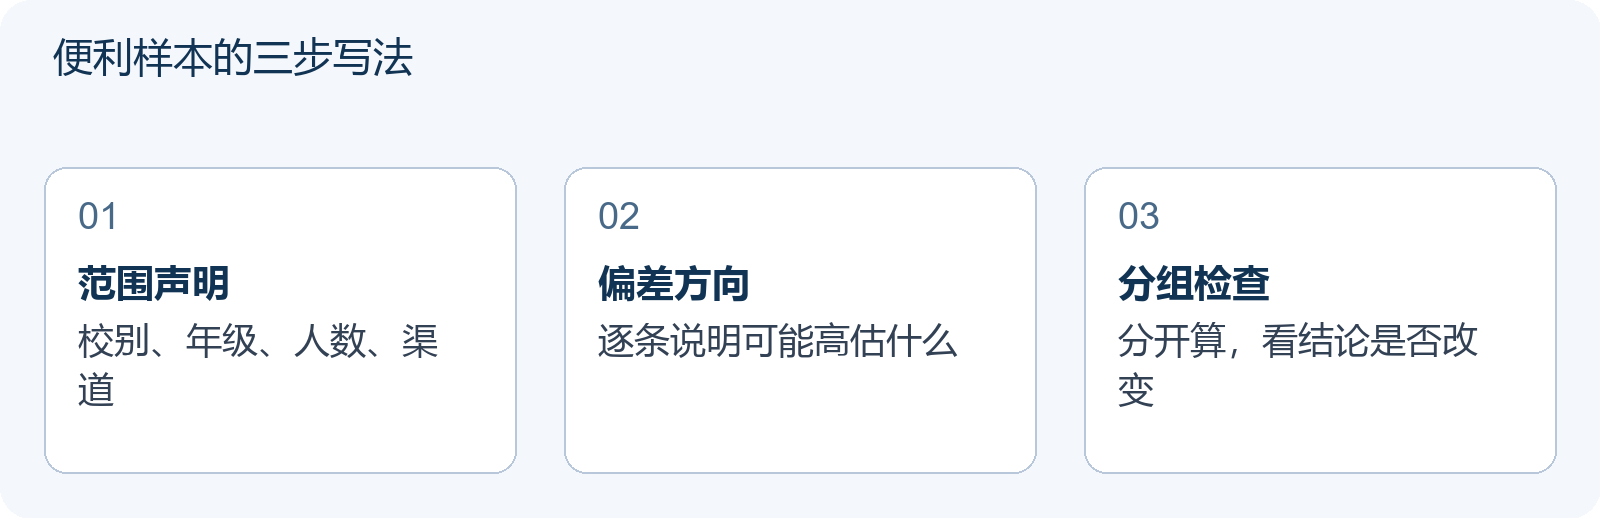
便利样本在校园研究里几乎是必然选择,它不是错误,把它写成随机样本才是错误。可辩护的写法有三步。
第一步,范围声明。在方法与局限中各写一次:“本研究样本为某校高一至高三通过班级统一组织与家长群自愿转发招募的120名学生,结论限于该群体。”范围声明要具体到校别、年级、人数与渠道,不写“部分学生”。
第二步,偏差方向讨论。逐条说明哪些变量可能被推高或压低,以及渠道机制为何导致这一方向。例如“家长群转发更可能触达关注学业的家庭,因此课外投入时长可能被高估”。写方向、写原因,不写“无法排除偏差”这类空话。
第三步,分组敏感性检查。按渠道来源、年级、性别等分组重算关键比例,观察结论是否随分组改变。如果负相关只在家长群来源的子样本中出现,就应报告“关系在不同招募来源间不一致”,而不是合并后宣称成立。这里要克制:分组检查只能说明结论稳不稳,不能反过来“证明样本无偏”。
五、三句禁忌表述与三句替代表述
| 不建议写 | 问题所在 | 可辩护的替代写法 |
|---|---|---|
| “共回收200份,样本具有代表性。” | 把份数当代表性证据,未交代抽样机制 | “本样本在年级分布上与校方公布的在校生结构接近(附对比表),但家庭背景变量无从比对,故不主张全校代表性。” |
| “结果具有普遍意义。” | 结论范围远超样本覆盖 | “结果适用于本校本年级自愿参与者;能否外推到其他学校,需另行抽样检验。” |
| “问卷随机发放。” | 渠道其实是转发与自愿填写,与随机抽样不符 | “在三个年级各随机抽取两个班级,班内自愿填写,并报告实际回收率与缺席人数。” |
第三行尤其常见:随机的是“抽班级”,不是“抽人”,两个层次要分开写;同时报出回收率、缺席情况与无效卷处理,份数才可复核,否则读者无法判断这个数字是怎么来的。
六、教学示例:一份120份校园问卷的推演
以下为教学示例,用于说明推理方式,不是真实研究数据,也不代表任何评审口径。设定:学生研究“本校学生每日自主学习时长与自评睡眠质量的关系”。共回收120份,其中90份来自两个高二班级由老师统一组织填写,30份来自高二年级家长群转发链接。初步结果显示自主学习时长与睡眠质量呈负相关。
第一层推演:总体怎么写。由于样本仅来自高二,高一、高三未被覆盖,总体只能写成“某校高二两个班及高二年级家长群自愿参与者”,写“本校学生”即为超范围。
第二层推演:渠道机制。家长群转发的链接更可能被关注学业的家庭点开,因此该子样本的自主学习时长可能偏高;班级统一填写时同伴在场,自评睡眠可能受同班氛围影响。两者都可能让“学习投入”和“睡眠评价”偏离无偏估计。
第三层推演:分组检查。把90份班级样本与30份家长群样本分开计算,若负相关只在家长群子样本出现,正确写法是“关系在不同招募来源间不稳定,可能与样本来源有关”;只有当两个子样本方向一致时,才可以写成“在本样本的两个来源中均观察到负相关”。
最终结论的写法应是:“在某校部分高二学生中观察到自主学习时长与自评睡眠质量的负相关,样本来自班级统一组织与家长群自愿参与,结果不宜外推到全校或其他学校。”这句话比“高中生睡眠普遍受影响”弱,但每一句都能被招募记录支撑。
七、问卷、访谈与行为实验混用时怎么写样本
三类数据的总体往往不是同一群人:问卷来自愿意填写者,访谈来自愿意深谈者,行为实验来自能到场地并完成流程者。方法部分应分别交代各自的招募路径、人数与排除标准,不要用一个“共招募N人”概括三种来源,否则读者无法判断哪一部分支撑哪一句结论。
混合方法的价值在互补,不在互相背书:问卷给分布,访谈解释“为什么会出现这个分布”,但访谈中出现几次同样的说法,不能用来“验证”问卷中的比例。若同一名学生既填问卷又接受访谈,需说明是否在统计中重复计数,以及如何处理。
八、发放之前,先做一次研究设计复盘
与其等评委追问“这能代表谁”,不如在发放前把四件东西写在一页纸上:目标总体的一句话定义;招募渠道清单,以及每条渠道预计漏掉哪类人;问卷题目与目标构念的对应关系;提前写好的结论边界段落——先写“这份数据最多能说到哪”,发放后再回来核对。
带着这四项去和研究设计方面的老师沟通,比带一份还没收上来的问卷草稿更有效率:对方可以直接检查总体与渠道是否匹配、结论句是否越界,而不必替你重新构想一个课题。站内《ISEF研究局限怎么写:把无法控制的变量转成结论边界》可以作为这一步的对照材料。至于是否需要外部支持、需要到什么程度,取决于名单与渠道是否已经落实,这属于沟通时再判断的事。
最后重复一次顺序:总体—渠道—边界。把这三样写清楚,120份便利样本也能成为一份诚实、可辩护的研究;如果招募机制不变,更多份数只是重复同一覆盖缺口。
一般活动背景信息可参见赛事背景资料。
常见问题
问卷收多少份才算有代表性?
没有一个通用份数。代表性来自抽样机制与总体定义,而不是份数本身。用班级群和家长群招到的200份不会因为份数多就自动获得代表性;按名单分层抽到的80份也需要说明回收率与缺席情况。两者都要写清总体、渠道和结论边界。本文所依据的资料中也没有见到ISEF对问卷样本量设定统一门槛,所以不建议在论文里引用“至少N份”这类说法。
便利样本会不会让整个研究站不住脚?
从研究方法角度看,便利样本本身不是错误,校园研究里几乎是必然选择。真正的问题是把它写成随机样本,或把结论写成“具有普遍意义”。可辩护的做法是三步:写清范围声明、讨论偏差方向及其机制、做分组敏感性检查并如实报告结论是否随来源改变。这三步做不到位,份数再多也不解决问题。
在家长群转发链接,能写成随机发放吗?
不能。家长群转发属于自选样本,主动点开并完成的人进入样本,不关注此类信息的家庭被系统性漏掉。可以如实写成“通过年级家长群自愿转发招募”,并说明由此可能高估哪些变量。如果确实做了随机抽取,应写清随机发生在哪个层次,例如“各年级随机抽取两个班级,班内自愿填写”,并同时报告回收率与缺席情况。